Jak powstał 23-sekundowy film z AI: cztery podejścia
Chciałem pokazać rysowanie geometrii przez AI. Przeszedłem przez pierwszą narrację, systemową Zosię i ElevenLabs. Po drodze zmieniłem też sposób pokazania rysowania i tempo montażu.
- Cel
- W maksymalnie 30 sekund pokazać, jak agent AI rysuje geometrię budynku w AppEnergo — z widocznym działaniem i polską narracją.
- Narzędzia
Agent AI · AppEnergo · AVFoundation · Cap · Głos systemowy macOS — Zosia · ElevenLabs
- Proces
- Cztery wersje: pierwsza próba → właściwy rzut i systemowa Zosia → rysowanie z głosem Jacek → przywrócenie naturalnego tempa.
- Efekt
- Film 23,067 s, Full HD, 30 klatek/s, z głosem Jacek w oryginalnym tempie. Po korekcie skróciliśmy obraz bez ponownego generowania narracji.
Cztery próby — od pierwszego głosu do gotowego montażu
Oryginalne nagrania z polskim głosem syntetycznym. Opis pracy i ograniczenia demonstracji są w tekście poniżej. Odtwarzacze mają polskie napisy i ich angielskie tłumaczenie; wybierzesz je w menu napisów.
1. Pierwsza próba · 28 s
2. Systemowa Zosia · 28 s
3. Jacek — spowolniony · 28 s
4. Jacek — naturalne tempo · 23,067 s
Narzędzia i ich rola
- Agent AI i przeglądarka — agent obsługiwał lokalny edytor, rysował geometrię i przygotowywał materiał do kolejnych wersji. Ja wybierałem rzut, oceniałem obraz i głos oraz zatwierdzałem kierunek poprawek.
- AppEnergo — aplikacja, w której odbywał się pokaz: wgranie rzutu i rysowanie geometrii budynku.
- AVFoundation — narzędzia systemowe macOS użyte lokalnie do składania materiału z klatek i dźwięku.
- Cap — przygotowanie oprawy, montażu i eksportu filmu z narracją.
- Głos systemowy macOS — Zosia — próba polskiej narracji w drugiej wersji, zanim przeszedłem do ElevenLabs.
- ElevenLabs — próbki oraz polska narracja. Ostatecznie wybrałem głos Jacek — Deep Warm Studio Broadcast.
Proces: najpierw zawęziłem cel
Na początku planowałem pokazać w mniej niż pół minuty, jak agent AI pomaga narysować geometrię budynku w AppEnergo. Pomysł był szerszy: od wgrania rzutu, przez ustawienie skali i północy, obrys ścian, podział pomieszczeń, dach i podłogę, aż po import. To byłby jednak instruktaż, a nie krótki, atrakcyjny pokaz.
Zawęziłem zadanie. Film miał inspirować do użycia AI i trwać maksymalnie 30 sekund. Równie ważne było to, czego nie wystarczyło powiedzieć w briefie technicznym: widz miał zobaczyć rysowanie ścian, a nie serię gotowych ekranów.
Próba 1: prosty rzut i pierwsza narracja
Pierwsza wersja, na prostym rzucie testowym, trwała 28 sekund. Proces był widoczny, ale polska narracja nie brzmiała przekonująco. Po tej próbie potrzebowałem właściwego rzutu i lepszego głosu.
Próba 2: systemowa Zosia i właściwy rzut
W drugiej wersji użyliśmy wskazanego, bardziej realistycznego rzutu oraz systemowego głosu Zosia. Film trwał 28 sekund. Narracja nadal nie spełniała moich oczekiwań, a montaż składał się głównie ze statycznych ujęć. Zmiany potrzebowały więc zarówno głos, jak i sposób pokazania pracy.
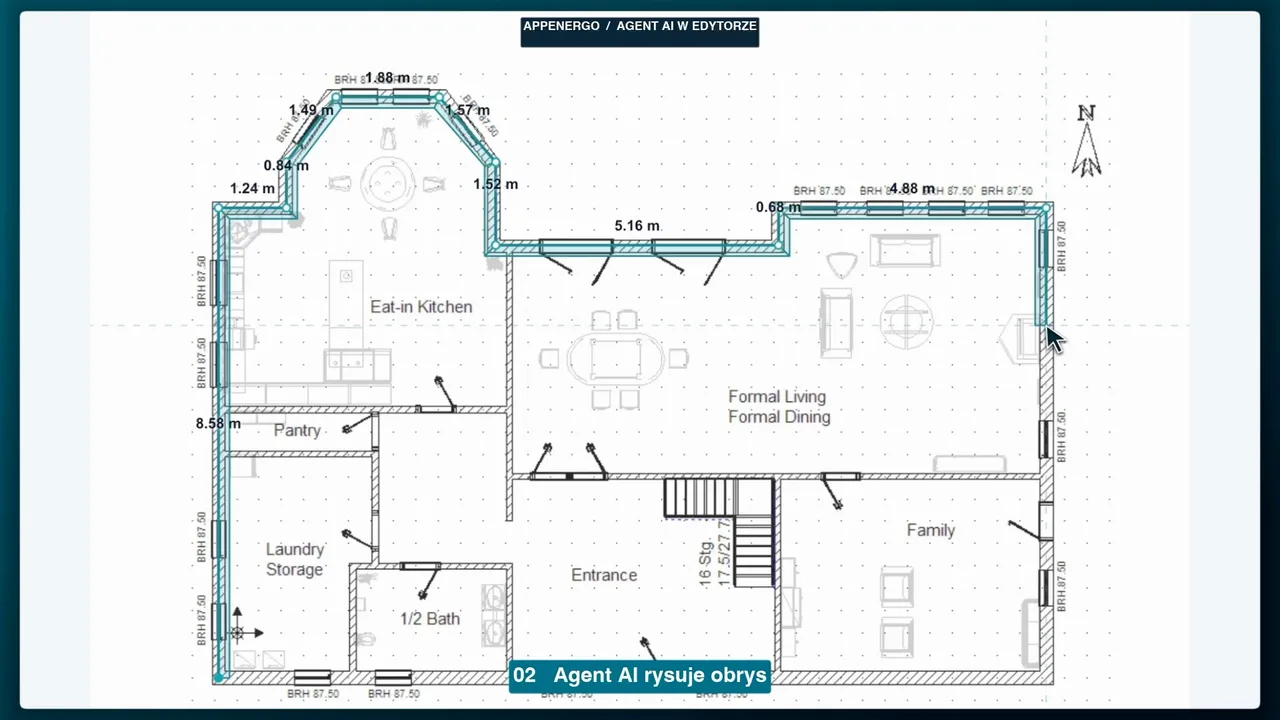
To był ważny moment: poprawny kontekst wizualny nie oznacza jeszcze, że film pokazuje pracę. Zamiast przechodzić od rezultatu do rezultatu, trzeba było pokazać działanie — kolejne odcinki ścian i tworzący się podział pomieszczeń. Agent sterował lokalnym edytorem i faktycznie rysował geometrię. Rejestrowaliśmy klatki strony oraz pozycje wykonywanych akcji, a w montażu pojawiła się powiększona strzałka. Nie był to natywnie nagrany wskaźnik systemowy, tylko czytelna wizualizacja rzeczywistych ruchów agenta. Do montażu i eksportu filmu użyliśmy Cap.
Próby przechwytywania całego okna trafiały też na zasłaniające je elementy. Dlatego ostateczny materiał złożyliśmy z klatek samej strony przeglądarki. To rozwiązało problem z czystością obrazu pokazu.
Próba 3: wybrałem głos, ale montaż go spowolnił
Polski tekst nie gwarantuje dobrej polskiej narracji. Odrzuciłem wcześniejsze głosy, a później porównałem próbki w ElevenLabs. Kupiłem dostęp do usługi, a po próbie Daniela wybrałem i potwierdziłem głos Jacek — Deep Warm Studio Broadcast.
W trzeciej wersji, trwającej 28 sekund, widać już rysowanie przez agenta. Problem pojawił się w dźwięku. Oryginalna narracja Jacka trwała około 21,4 sekundy, lecz w montażu rozciągnięto ją do 26 sekund, aby pasowała do przygotowanego obrazu. Wysokość głosu pozostała podobna, ale tempo i energia wyraźnie ucierpiały. To nie był argument przeciwko wybranemu lektorowi; błąd powstał przy dopasowaniu audio do filmu.
Próba 4: dopasowaliśmy obraz do głosu
Naprawa była prostsza niż generowanie kolejnej narracji. Przywróciliśmy oryginalne tempo audio, skróciliśmy obraz i wyeksportowaliśmy czwartą wersję o długości 23,067 sekundy. Zamiast wymuszać tempo lektora, montaż dostosowano do głosu. Nie regenerowaliśmy narracji.
Efekt: 23 sekundy i zachowane tempo narracji
Powstał plik Full HD przy 30 klatkach na sekundę, przekazany do pobrania. Cztery wersje powyżej pokazują drogę od pierwszej próby, przez systemową Zosię, do Jacka z ElevenLabs. Dwie ostatnie pozwalają dodatkowo porównać tempo: 28 sekund z rozciągniętą narracją oraz 23,067 sekundy z oryginalnym tempem głosu. Samo zapisanie pliku nie jest jeszcze pełnym odbiorem jakości ani publikacją.
Praktyczna zasada z tej próby jest prosta: zanim rozciągniesz wybraną ścieżkę głosową, odsłuchaj ją w docelowym montażu. Jeśli energia znika, najpierw skróć lub przebuduj obraz.
Co dokładnie pokazuje ten film
To przyspieszona, zmontowana demonstracja, a 23 sekundy są długością filmu, nie zmierzonym czasem wykonania całego zadania. Film pokazuje agenta obsługującego istniejący edytor; nie dowodzi automatycznego rozpoznawania całego planu ani nowej funkcji AppEnergo. Podział pomieszczeń jest przykładowy, a odcinek referencyjny 15 m przyjęto na potrzeby demonstracji — nie potwierdza on wymiarów planu ani poprawności geometrii.
Końcowy ekran udanego importu pochodzi z wcześniejszego udanego importu w tej samej demonstracji. Nie jest dowodem nowego importu każdej nagranej wersji obrysu. Z tej pracy zostaje mi prosta zasada: agent może wykonać działania, ale to ja muszę zdecydować, co ma być widoczne, jak ma brzmieć i kiedy materiał jest wystarczająco czytelny.